React Server Components 디버깅·관측성 가이드: Next.js App Router 운영 오류를 추적하는 기준

결론: RSC 장애는 ‘프론트 버그’가 아니라 경계·캐시·요청 흐름의 추적 문제다
Next.js App Router와 React Server Components를 운영할 때 가장 먼저 정해야 할 것은 어떤 화면을 Server Component, Client Component, Route Handler, Server Action으로 나눌지가 아니라, 장애가 났을 때 이 네 영역을 어떤 ID와 로그 포맷으로 다시 이어볼 것인지입니다. 브라우저 콘솔에는 hydration 오류만 보이고, 서버 로그에는 렌더 예외만 남고, 백엔드 API에는 정상 응답이 찍히는 상황이 흔합니다. 관리자 화면에서 데이터가 오래 보이거나, Server Action은 실패했는데 버튼은 성공처럼 보이거나, 특정 고객사에서만 화면 전환이 느린 문제는 대부분 한 화면 안에서 여러 실행 환경이 섞이기 때문에 발생합니다.
운영 관점의 답은 단순합니다. 첫째, 사용자 요청·라우터 전환·서버 렌더·Server Action·캐시 재검증을 하나의 trace_id 또는 request_id로 묶습니다. 둘째, error.tsx, global-error.tsx, instrumentation.ts, instrumentation-client.ts가 각각 어떤 오류를 잡는지 역할을 분리합니다. 셋째, 캐시 무효화는 개발자가 기억으로 처리하지 않고, 페이지별 cache tag와 revalidation 정책표로 관리합니다.
RSC 관측성의 목표는 모든 내부 payload를 저장하는 것이 아닙니다. 운영자가 ‘어느 경계에서, 어떤 tenant와 route에서, 어떤 mutation 이후, 어떤 캐시 상태로 문제가 재현됐는지’를 10분 안에 좁히게 만드는 것입니다.
1. App Router 오류가 흩어져 보이는 이유
App Router에서는 기본적으로 layout과 page가 Server Component로 동작하고, 상호작용·브라우저 API·상태가 필요한 부분만 Client Component로 분리합니다. 서버에서는 Server Component 트리가 RSC Payload라는 직렬화된 형태로 만들어지고, 클라이언트는 이를 이용해 Client Component와 서버 렌더 결과를 맞춥니다. 이 구조 덕분에 브라우저로 보내는 JavaScript를 줄일 수 있지만, 장애 분석 지점은 늘어납니다.
예를 들어 SaaS 관리자 화면의 ‘고객사 설정 저장’ 버튼을 누르면 실제로는 다음 일이 이어질 수 있습니다. Client Component의 클릭 이벤트가 Server Action을 호출하고, Server Action이 권한을 검사한 뒤 DB를 수정하고, updateTag 또는 revalidatePath를 호출하고, 같은 응답 안에서 현재 route의 RSC Payload가 다시 내려오며 UI가 갱신됩니다. 이 중 하나라도 로그가 빠지면 사용자는 ‘저장이 됐는데 화면이 그대로다’라고 말하고, 개발팀은 ‘DB에는 저장됐다’고 답하는 식의 책임 공방이 생깁니다.
따라서 RSC 디버깅은 React 컴포넌트만 보는 일이 아닙니다. 운영 로그, 캐시 정책, 배포 환경, 고객사 권한, 브라우저 라우터 전환을 함께 보는 문제입니다. 캐시 전략 자체가 흔들리는 서비스라면 먼저 Next.js 캐시·CDN 전략 가이드에서 route별 Cache-Control과 revalidation 기준을 정리한 뒤 관측성을 붙이는 편이 안전합니다.
2. 운영에서 자주 보이는 증상과 먼저 볼 신호
| 증상 | 먼저 의심할 영역 | 확인할 신호 | 주의할 점 |
|---|---|---|---|
| 개발 환경에서는 되는데 운영에서 Server Component 오류가 난다 | 서버·클라이언트 경계, 환경변수, 런타임 차이 | routePath, renderSource, error digest, 배포 SHA | 운영에서는 민감정보 노출 방지를 위해 클라이언트에 원본 오류가 그대로 보이지 않을 수 있다. |
| 페이지 이동이 특정 고객사에서만 느리다 | tenant별 데이터 크기, 권한 필터, fetch waterfall, 캐시 미스 | navigation start, RSC 응답 duration, DB query duration, tenant_id 해시 | 브라우저 성능만 보면 서버 렌더 지연과 구분하기 어렵다. |
| 저장 성공 토스트가 떴지만 목록이 갱신되지 않는다 | Server Action 반환값과 revalidation 정책 불일치 | action_name, result_code, 호출한 revalidatePath 또는 tag, 이후 RSC 재렌더 여부 | router.refresh는 서버 캐시 무효화가 아니다. |
| 관리자 목록에서 오래된 값이 간헐적으로 보인다 | cache tag 누락, path 기반 재검증 범위 부족, CDN 캐시 | cache tag, cache age, revalidation reason, response header | 같은 데이터를 여러 route에서 쓰면 path만 무효화해서는 부족할 수 있다. |
| 브라우저 콘솔에 hydration 또는 직렬화 오류가 난다 | Client Component props, browser API 사용 위치, 'use client' 범위 | component boundary, props type, RSC payload 전후 route | payload 원문 저장보다 props 종류와 boundary 위치 기록이 더 안전하다. |
3. 최소 관측성 구조: 네 군데에 같은 사건 ID를 심는다
작은 팀도 처음부터 복잡한 APM 대시보드를 만들 필요는 없습니다. 대신 다음 네 군데에 같은 사건 ID를 남겨야 합니다.
- 클라이언트: 라우터 전환 시작 시각, 이동 대상 URL, navigation type, 브라우저 오류, 사용자 조작 직전 화면 상태.
- Next.js 서버 렌더: routePath, routeType, renderSource, render duration, error digest, runtime, deployment id.
- Server Action·Route Handler: action_name 또는 handler_name, 입력 검증 결과 코드, 권한 결과, mutation 대상, revalidation 호출 내역.
- 백엔드·DB·캐시: 외부 API duration, DB query duration, cache key 또는 tag, cache hit/miss, 재검증 사유.
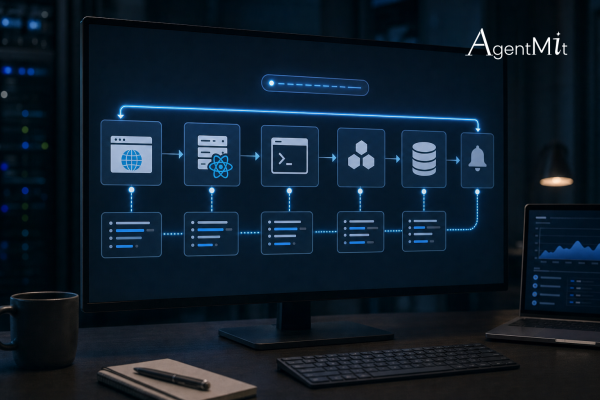
핵심은 ID의 이름보다 전파입니다. 프록시나 Edge 계층에서 x-request-id를 만들었다면 Next 서버 로그, Server Action 로그, API 로그, 오류 리포트에 모두 들어가야 합니다. 클라이언트에서 시작되는 라우터 전환은 서버 요청과 1:1로 딱 맞지 않을 수 있으므로 navigation_id와 request_id를 모두 저장하는 편이 실무적으로 유용합니다.
권장 로그 필드
| 필드 | 예시 | 쓰임 |
|---|---|---|
ts, level, env | 2026-10-06T10:31:22Z, error, prod | 기본 필터링 |
trace_id, request_id, navigation_id | trc_..., req_..., nav_... | 브라우저·서버·API 로그 연결 |
route_path, route_type, render_source | /app/admin/users/[id], action, react-server-components-payload | App Router 장애 위치 파악 |
tenant_id_hash, user_id_hash | sha256 일부 | 특정 고객사 재현 여부 확인 |
action_name, result_code | updateCompanySetting, VALIDATION_FAILED | Server Action 실패 분류 |
cache_tag, revalidate_call, cache_age_ms | company:123, updateTag, 42000 | 오래된 데이터 원인 추적 |
duration_ms, status, error_digest | 1230, 500, digest... | 알림과 에러 경계 연결 |
개인정보와 영업정보는 원문으로 남기지 않습니다. 특히 관리자 화면은 고객사명, 이메일, 결제 상태, 내부 메모가 props에 섞이기 쉽습니다. RSC Payload 원문을 저장하는 방식은 진단 효율보다 보안 위험이 커질 수 있습니다. 필요한 것은 payload의 전체 내용이 아니라 어느 route segment에서, 어떤 크기와 지연으로, 어떤 캐시 상태에서 내려왔는지입니다.
4. instrumentation.ts는 ‘서버 관측성의 진입점’으로 본다
Next.js는 프로젝트 루트 또는 src 안에 instrumentation.ts를 두고 register 함수를 export하는 방식을 제공합니다. 이 함수는 새 서버 인스턴스가 요청을 받기 전에 실행되므로 OpenTelemetry, 로거 초기화, 런타임별 설정을 넣기에 적합합니다. 또한 onRequestError를 통해 Next 서버가 포착한 오류를 관측성 시스템으로 보낼 수 있습니다.
export const (err, request, context) => { log.error({ event: 'next_request_error', path: request.path, routeType: context.routeType, renderSource: context.renderSource, digest: err.digest }) }여기서 중요한 값은 context.routeType입니다. 같은 500 오류라도 Server Component 렌더링 중 난 오류인지, Route Handler에서 난 오류인지, Server Action에서 난 오류인지에 따라 담당자와 복구 방법이 달라집니다. renderSource와 revalidateReason도 캐시 불일치나 RSC payload 문제를 좁히는 데 도움이 됩니다.
다만 onRequestError를 만능으로 보면 안 됩니다. 입력값 검증 실패, 권한 없음, 재고 부족처럼 정상 비즈니스 흐름에서 발생하는 expected error는 예외로 던져서 error boundary에 맡길 문제가 아닙니다. 이런 값은 Server Action의 반환값으로 모델링하고, 별도의 result_code로 집계해야 제품 지표와 장애 지표가 섞이지 않습니다.
5. instrumentation-client.ts는 ‘느린 화면 전환’의 시작점을 잡는다
느린 화면 전환은 사용자에게는 하나의 경험이지만 내부적으로는 여러 구간으로 나뉩니다. 클릭 후 라우터 전환이 시작되기까지, RSC 요청이 서버로 가기까지, 서버 렌더가 끝나기까지, 클라이언트가 payload를 병합하기까지 시간이 각각 다를 수 있습니다. instrumentation-client.ts는 앱이 interactive해지기 전 초기 모니터링과 오류 추적, 라우터 전환 시작 이벤트를 심는 위치로 사용할 수 있습니다.
운영에서 유용한 클라이언트 이벤트는 다음과 같습니다.
router_transition_start: 이동 대상 URL, navigation type, 이전 route, navigation_id.client_error: message, stack 요약, 현재 route, user agent, release version.action_click: 버튼 이름, action_name, optimistic UI 사용 여부.web_vital: LCP, INP, CLS 같은 사용자 경험 지표. 단, RSC 원인 분석에는 서버 trace와 연결해야 의미가 커진다.
클라이언트 instrumentation은 가벼워야 합니다. 모니터링 코드 자체가 초기 로딩을 지연시키면 원인 분석 도구가 원인이 됩니다. 이벤트를 모두 즉시 전송하기보다 샘플링, 배치 전송, 실패 시 무시 정책을 정해야 합니다.
6. Server Component와 Client Component 경계는 ‘장애 책임선’이다
'use client'는 단순히 파일 하나를 클라이언트로 보내는 표시가 아닙니다. 해당 모듈과 하위 의존성이 클라이언트 코드로 평가되는 경계를 만듭니다. 반대로 Server Component는 서버에서 데이터 접근, secret 사용, 렌더링을 처리할 수 있습니다. 운영에서는 이 경계를 다음 기준으로 나누는 것이 좋습니다.
| 화면 성격 | 권장 구조 | 남길 로그 | 흔한 실수 |
|---|---|---|---|
| 마케팅 랜딩 | Server Component 중심, 필요한 CTA만 Client Component | route render time, cache status, Web Vitals | 작은 인터랙션 때문에 상위 전체에 'use client'를 붙임 |
| SaaS 대시보드 | 데이터 영역은 Server Component, 필터·차트 조작은 client island | tenant_id_hash, query duration, segment별 loading time | 모든 데이터를 클라이언트 fetch로 다시 가져와 RSC 장점을 없앰 |
| 관리자 CRUD | Server Action 또는 Route Handler로 mutation, 명확한 revalidation | action_name, validation_code, revalidate_call, audit_id | DB 수정 후 캐시 tag 갱신을 빠뜨림 |
| 실시간·고상호작용 화면 | Client Component와 별도 API, WebSocket, polling 조합 검토 | client event, API latency, reconnect count | RSC로 처리할 화면과 client state 화면을 억지로 합침 |
AgentMit가 SaaS·관리자 화면을 설계할 때도 RSC를 무조건 많이 쓰는 방향으로 보지 않습니다. 고객사별 권한, 데이터 신선도, 수정 빈도, 감사 로그 필요성을 먼저 보고 Server Component, Client Component, Route Handler, Server Action의 책임을 나눕니다. 특히 BizMit처럼 내부 운영과 고객 관리가 결합된 화면은 ‘누가 언제 무엇을 바꿨고 화면은 언제 갱신됐는지’가 제품 기능만큼 중요합니다.
7. Server Actions 실패는 ‘예상 실패’와 ‘예외’를 분리해야 한다
Server Action은 mutation을 화면 코드와 가깝게 둘 수 있어 편리하지만, 운영 로그가 느슨하면 가장 헷갈리는 지점이 됩니다. React의 Server Function은 클라이언트에서 호출될 때 네트워크 요청으로 처리되며 인자와 반환값은 직렬화 가능해야 합니다. Next.js의 Server Action은 현재 route의 재렌더와 RSC Payload 갱신까지 한 응답에 묶일 수 있어, 성공·실패·UI 갱신이 한 번에 보입니다.
그래서 실패 분류가 필요합니다.
| 분류 | 예시 | UI 처리 | 로그 레벨 |
|---|---|---|---|
| expected error | 필수값 누락, 권한 없음, 중복 이름 | useActionState 등으로 메시지 표시 | warn 또는 info, result_code 필수 |
| 외부 의존성 실패 | 결제 API timeout, 파일 업로드 실패 | 재시도 안내, 보상 처리 검토 | warn 또는 error, provider와 duration 기록 |
| 버그성 예외 | 직렬화 불가 반환값, null 접근, DB 스키마 불일치 | error boundary fallback | error, digest와 stack 요약 기록 |
| 보안 차단 | Origin 불일치, body size 초과, 인증 만료 | 로그인 유도 또는 차단 메시지 | warn, origin·host·user_id_hash 기록 |
Server Actions 설정에는 허용 origin과 body size limit처럼 운영에서 바로 장애로 보일 수 있는 항목이 있습니다. reverse proxy, 터널, 사내망 도메인을 쓰는 프로젝트는 Origin과 Host가 어떻게 전달되는지 배포 전에 확인해야 합니다. 파일이나 큰 form 데이터를 Server Action으로 보낼 때도 기본 제한과 multipart 오버헤드를 고려해야 합니다.
8. 캐시 불일치는 revalidatePath, revalidateTag, updateTag의 책임표로 잡는다
운영 장애 중 가장 설명하기 어려운 것이 ‘어떤 사람에게는 새 값, 어떤 사람에게는 이전 값’입니다. App Router에서 캐시를 쓰는 순간 이 문제는 자연스럽게 생길 수 있습니다. 중요한 것은 어떤 데이터가 어느 화면에서 쓰이는지, mutation 이후 어느 범위까지 즉시 신선해야 하는지를 표로 관리하는 것입니다.
| 상황 | 우선 검토 | 운영 기준 |
|---|---|---|
| 현재 화면에서 내가 방금 수정한 값이 바로 보여야 한다 | updateTag 또는 즉시 재렌더를 유발하는 흐름 | read-your-own-writes가 필요한 관리자 기능에 적합 |
| 블로그·상품 목록처럼 잠시 stale 허용 가능 | revalidateTag | background refresh 허용 여부를 제품 정책으로 명시 |
| 특정 route만 다시 만들면 된다 | revalidatePath | 같은 데이터를 다른 route가 쓰는지 반드시 확인 |
| 버튼 클릭 후 현재 route만 다시 요청하고 싶다 | router.refresh | 서버 캐시를 무효화하지 않는다는 점을 로그에 남김 |
캐시 정책표에는 최소한 data source, cache tag, 사용 route, mutation action, 무효화 방식, 허용 stale 시간, 담당자가 들어가야 합니다. 정부지원 MVP나 초기 SaaS는 이 표가 없어도 출시할 수는 있지만, 고객사가 늘어나면 특정 고객사 데이터만 오래 보이는 문제를 재현하기 어려워집니다.
9. 재현은 ‘hard load와 soft navigation’을 분리해서 시작한다
RSC 운영 이슈는 재현 절차가 느슨하면 매번 다른 결론이 나옵니다. 다음 순서로 좁히면 원인 분리가 빠릅니다.
- 직접 URL 진입과 앱 내부 이동을 분리합니다. 새 탭에서 URL을 열 때와 <Link> 또는 router navigation으로 이동할 때 결과가 다른지 봅니다.
- hard refresh와 router.refresh를 구분합니다. hard refresh는 브라우저·네트워크 계층을 새로 시작하지만, router.refresh는 현재 route를 서버에 다시 요청하되 서버 캐시 무효화와는 별개입니다.
- 같은 tenant, 같은 권한, 같은 feature flag로 재현합니다. SaaS 관리자 화면의 문제는 권한 필터나 고객사 데이터량에 따라 달라지는 경우가 많습니다.
- 운영과 비슷한 빌드로 봅니다.
next dev와next build/next start는 동작과 최적화가 다릅니다. 로컬 개발 로그는 원인 후보를 찾는 도구이지 운영 재현의 대체물이 아닙니다. - 배포 SHA와 환경변수 버전을 기록합니다. RSC 경계 오류는 코드 변경뿐 아니라 런타임, 패키지 버전, Edge/Node 차이에서 생길 수 있습니다.
테스트 자동화까지 같이 정리하려면 Next.js App Router 테스트 전략 가이드를 함께 보는 것이 좋습니다. 관측성은 장애 이후의 눈이고, 테스트는 장애 이전의 안전망입니다. 둘 중 하나만 있으면 운영 비용이 줄어드는 폭이 제한적입니다.
10. 알림 기준은 ‘프레임워크 오류’가 아니라 ‘운영 의사결정’ 단위로 만든다
알림은 많을수록 좋은 것이 아닙니다. 다음 기준처럼 실제 대응 행동이 달라지는 단위로 쪼개야 합니다.
- 같은 error digest가 같은 route에서 반복: 최근 배포 롤백 또는 해당 route feature flag 차단 검토.
- Server Action expected error 급증: UI 검증 누락, 권한 정책 변경, 외부 API 정책 변경 확인.
- 특정 tenant의 navigation latency 악화: 데이터량, 권한 필터, DB index, 캐시 tag 누락 확인.
- revalidation 실패 또는 cache age 초과: 관리자 데이터 신선도 영향 여부 확인 후 수동 재검증 또는 캐시 purge.
- Route Handler 5xx 증가: 백엔드 의존성, DB pool, 인증 토큰 만료, 배포 region 확인.
각 알림에는 owner, 1차 확인 대시보드, 롤백 기준, 고객 공지 필요 여부가 붙어야 합니다. 단순히 Slack에 500이 찍히는 것은 알림이 아니라 소음에 가깝습니다.
11. 배포 전 체크리스트
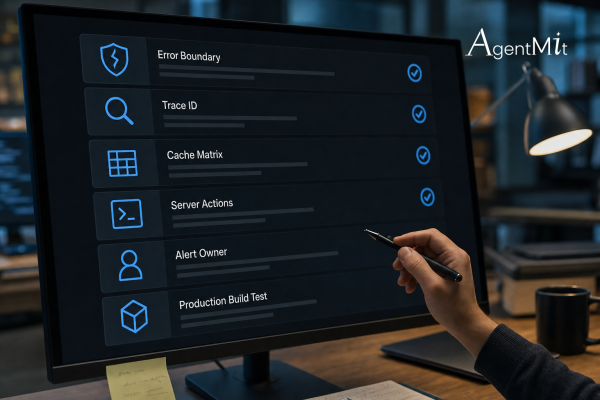
| 점검 항목 | 확인 질문 | 미흡할 때의 위험 |
|---|---|---|
| 경계 설계 | 상호작용이 필요한 부분만 Client Component인가? | 불필요한 JS 증가, hydration 오류 원인 확대 |
| 오류 경계 | 주요 route segment에 error.tsx와 fallback UX가 있는가? | 한 영역 오류가 전체 화면 장애로 보임 |
| Server Action 결과 | expected error가 반환값과 result_code로 분리되어 있는가? | 사용자 오류와 시스템 장애가 같은 error로 집계됨 |
| Trace ID | 브라우저 이벤트, 서버 렌더, action, API 로그가 연결되는가? | 특정 고객사 장애를 재현하지 못함 |
| 캐시 정책표 | mutation별 revalidatePath, revalidateTag, updateTag 기준이 문서화됐는가? | 저장은 됐지만 화면이 오래 보이는 문제 반복 |
| 운영 빌드 검증 | next build/next start 또는 실제 배포와 가까운 환경에서 확인했는가? | 개발 환경에서만 보이는 로그에 의존 |
| 개인정보 마스킹 | props, formData, payload 원문을 저장하지 않는가? | 로그 시스템이 개인정보 저장소가 됨 |
| 배포 전략 | 문제가 생기면 route 단위 차단, feature flag, 롤백 중 무엇을 할지 정했는가? | 장애 대응이 사람의 기억에 의존 |
배포 환경 선택 자체가 아직 정리되지 않았다면 Next.js 배포 전략 가이드에서 서버리스, Edge, Node 서버, Docker의 운영 차이를 먼저 비교해 보십시오. 관측성 설계는 배포 형태에 따라 수집 가능한 로그, trace export 방식, 런타임 제약이 달라집니다.
12. AgentMit 관점: RSC 도입보다 운영 책임선을 먼저 정한다
React Server Components는 좋은 도구지만 모든 화면의 정답은 아닙니다. 랜딩 페이지, SaaS 대시보드, 사내 관리자, 고객사별 리포트 화면은 데이터 신선도와 상호작용 밀도가 다릅니다. AgentMit는 Next.js 기반 AI 서비스, SaaS, 자동화 관리자 화면을 설계할 때 RSC 적용 여부보다 먼저 다음 산출물을 정리합니다.
- 페이지별 Server Component·Client Component·Route Handler·Server Action 책임표
- Server Action별 expected error 코드와 감사 로그 기준
- 캐시 tag, path revalidation, 사용자별 stale 허용 기준
- trace_id와 structured log 필드 정의
- 운영 알림 owner와 장애 대응 runbook
이미 운영 중인 Next.js App Router 서비스에서 장애 원인 추적이 어렵거나, 정부지원 MVP 이후 SaaS 관리자 화면을 장기 운영 구조로 리팩터링해야 한다면 구현보다 먼저 로그와 책임선 설계를 점검하는 편이 비용을 줄입니다. 필요한 경우 AgentMit는 BizMit 운영 경험을 바탕으로 Next.js 화면 구조, 관리자 기능, 자동화, AI 기능, 배포·관측성까지 이어지는 개선 범위를 함께 정리할 수 있습니다.
참고자료
이 글은 2026년 10월 기준 공식 문서의 App Router, Server Components, instrumentation, Server Actions, revalidation 내용을 운영 설계 관점으로 재구성했습니다. 세부 API는 프로젝트의 Next.js와 React 버전에 따라 달라질 수 있으므로 적용 전 사용 중인 버전의 문서를 확인해야 합니다.