AI 에이전트 오케스트레이션 설계 가이드: 작업 분해·도구 호출·재시도·승인 흐름 기준

결론부터 말하면, 기업용 AI 에이전트 오케스트레이션은 ‘LLM에게 업무를 맡기는 것’이 아니라 ‘LLM이 요청할 수 있는 업무 실행 경로를 제한된 코드, 상태, 승인, 로그 안에 넣는 것’입니다. 챗봇처럼 한 번 답변하고 끝나는 구조로 CRM 수정, ERP 조회, 결제 취소, 메일 발송, 관리자 기능 호출을 붙이면 중복 실행, 권한 오남용, 비용 폭증, 감사 불가능 문제가 생깁니다. 따라서 설계 순서는 프롬프트 작성이 아니라 업무 분해, 도구 계약, 상태 저장, 승인 조건, 재시도와 롤백, 비용 한도, 관측 로그 순서로 가야 합니다.
이 글은 스타트업 대표, 정부지원사업 PM, SaaS 운영자, 마케터, 비개발 의사결정자가 개발팀이나 외주사와 같은 언어로 논의할 수 있도록 작성했습니다. 특정 프레임워크 홍보가 아니라, 실제 업무 시스템에 AI 에이전트를 붙일 때 어떤 결정을 먼저 내려야 하는지에 초점을 둡니다.
1. 챗봇과 AI 에이전트 오케스트레이션의 차이
챗봇은 주로 사용자의 질문을 이해하고 답변을 생성합니다. 반면 에이전트는 답변 중간에 문서를 검색하고, 고객 정보를 조회하고, 조건을 판단하고, 외부 API를 호출하며, 경우에 따라 업무 상태를 바꿉니다. 이 차이 때문에 운영 리스크가 완전히 달라집니다.
에이전트 설계의 핵심 질문은 ‘모델이 무엇을 말할 수 있는가’가 아니라 ‘모델이 어떤 조건에서 어떤 업무 행위를 요청할 수 있는가’입니다.
예를 들어 B2B SaaS 고객지원 에이전트를 만든다고 해보겠습니다. 단순 챗봇이라면 도움말 문서를 찾아 답변하면 됩니다. 하지만 에이전트가 되면 고객 플랜 확인, 미납 여부 조회, 환불 가능성 판단, CS 티켓 생성, 담당자 배정, 사과 메일 초안 작성, 승인 후 발송까지 이어질 수 있습니다. 여기서 환불, 메일 발송, 권한 변경은 모두 외부 상태를 바꾸는 행위입니다. 이 지점부터는 프롬프트보다 오케스트레이션이 중요합니다.
2. 먼저 업무를 두 종류로 나눈다
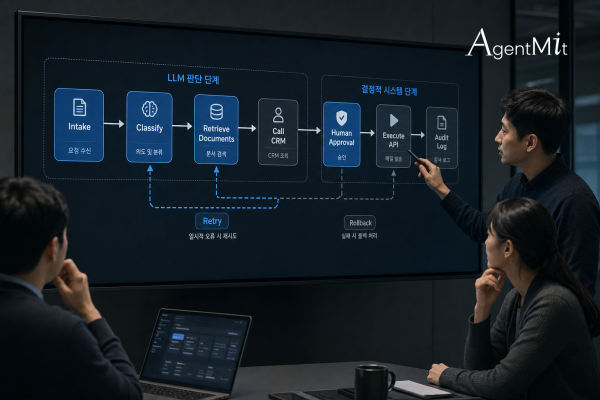
실무에서 가장 효과적인 출발점은 전체 업무를 결정적 단계와 LLM 판단 단계로 나누는 것입니다. 결정적 단계는 코드와 정책으로 처리해야 하는 단계입니다. LLM 판단 단계는 분류, 요약, 초안 작성, 모호한 의도 해석처럼 자연어 판단이 필요한 단계입니다.
| 업무 단계 | 예시 | 주 담당 | 설계 기준 |
|---|---|---|---|
| 입력 수집 | 문의, 이메일, 신청서, 업로드 문서 | 시스템 | 원문 보존, 사용자 ID, 수신 채널, 첨부파일 해시 저장 |
| 의도 분류 | 환불, 장애, 견적, 기능 문의 | LLM | 정해진 카테고리와 신뢰도, 근거 문장 저장 |
| 정보 조회 | CRM 고객등급, 결제 내역, 문서 검색 | 도구 API | 읽기 전용 권한, 캐시, 개인정보 최소 조회 |
| 업무 판단 | 환불 가능 여부, 담당팀 배정 | 코드와 LLM 혼합 | 정책 규칙은 코드, 모호한 사유 요약은 LLM |
| 실행 | 티켓 생성, 메일 발송, 상태 변경 | 도구 API | idempotency key, 승인 여부, 실패 처리 필요 |
| 검증 | 결과 확인, 후속 알림 | 시스템 | 실행 결과를 다시 조회해 실제 반영 여부 확인 |
이렇게 나누면 불필요한 에이전트 자율성을 줄일 수 있습니다. 예를 들어 ‘고객 등급이 Enterprise이면 CSM에게 배정한다’는 정책은 LLM에게 맡길 필요가 없습니다. 반면 ‘고객 불만의 핵심 사유를 2문장으로 요약한다’는 작업은 LLM이 잘할 수 있습니다.
3. 작업 분해 기준: 노드는 작게, 상태는 명시적으로
에이전트가 실패했을 때 어디서 다시 시작할지 알 수 없다면 실서비스에 넣기 어렵습니다. 그래서 작업을 한 덩어리 프롬프트로 처리하지 말고, 노드 또는 단계 단위로 쪼개야 합니다. LangGraph 문서가 강조하는 것처럼 업무를 이산적인 단계로 나누고 각 단계가 공유 상태를 읽고 쓰게 하면, 중간 상태 확인, 재시도, 사람 승인, 장애 복구가 쉬워집니다.
- 좋은 노드: 고객 정보 조회, 문서 검색, 초안 작성, 승인 대기, 메일 발송처럼 한 가지 책임이 분명합니다.
- 나쁜 노드: 문의를 이해하고 검색하고 환불하고 메일까지 보내는 하나의 거대 함수입니다.
- 상태 저장 원칙: 프롬프트 문자열보다 원문 데이터, 분류 결과, 도구 입력값, 도구 결과, 승인 기록을 저장합니다.
- 재개 기준: 사람 승인이 하루 뒤에 와도 같은 run_id와 checkpoint에서 이어갈 수 있어야 합니다.
초기 MVP라면 모든 단계를 그래프 엔진으로 만들 필요는 없습니다. 하지만 최소한 run_id, step_id, tool_call_id, user_id, 승인 상태, idempotency_key는 설계 문서에 들어가야 합니다. 이 값들이 없으면 장애 분석과 비용 분석이 거의 불가능합니다.
4. 도구 호출은 API가 아니라 권한 있는 업무 행위다
AI 에이전트에서 도구는 단순한 함수 호출이 아닙니다. 도구는 고객 정보를 읽거나, 문서를 검색하거나, 결제를 취소하거나, 운영 DB를 수정할 수 있는 업무 권한입니다. 따라서 도구 정의서는 API 명세서보다 더 엄격해야 합니다.
도구 정의서에 반드시 들어갈 항목
| 항목 | 질문 | 예시 |
|---|---|---|
| 도구 목적 | 이 도구는 무엇을 위해 존재하는가? | 고객 구독 상태 조회 |
| 권한 범위 | 누구의 어떤 데이터까지 접근 가능한가? | 현재 로그인 사용자의 소속 조직 데이터만 |
| 입력 스키마 | 필수값과 허용 범위는 무엇인가? | customer_id, organization_id |
| 출력 스키마 | 모델에게 어떤 형태로 돌려줄 것인가? | plan, status, next_billing_date |
| 부작용 | 외부 상태를 바꾸는가? | 조회는 없음, 환불은 결제 상태 변경 |
| 멱등성 | 같은 입력을 여러 번 실행해도 안전한가? | 티켓 생성은 key 없으면 중복 위험 |
| 승인 조건 | 자동 실행 가능한가, 사람 승인이 필요한가? | 환불, 삭제, 외부 발송은 승인 |
| 실패 처리 | 재시도, 보류, 보상 트랜잭션 중 무엇인가? | 429는 재시도, 결제 실패는 사람 확인 |
MCP를 사용한다면 readOnlyHint, destructiveHint, idempotentHint, openWorldHint 같은 도구 힌트가 유용합니다. 다만 이 값은 어디까지나 힌트입니다. 신뢰하지 않는 서버가 제공한 도구 설명만 보고 자동 승인하면 안 됩니다. 기업 내부에서는 MCP 서버를 등록할 때 보안 검토, 권한 스코프, 토큰 audience 검증, 로그 정책을 함께 봐야 합니다.
특히 MCP 서버가 다른 SaaS나 사내 API를 대신 호출한다면 token passthrough를 경계해야 합니다. 클라이언트에서 받은 토큰을 그대로 downstream API에 넘기는 구조는 권한 경계가 흐려질 수 있습니다. MCP 권한 설계는 OAuth만 붙였다고 끝나는 문제가 아니라, 어떤 리소스용 토큰인지 검증하고 도구별 최소 권한을 적용하는 문제입니다.
5. 재시도와 롤백은 모델이 아니라 정책이 결정한다
에이전트가 API 오류 메시지를 보고 ‘다시 해볼게요’라고 판단하게 두면 위험합니다. 재시도는 도구별 정책이어야 하며, 롤백은 가능 여부를 사전에 분류해야 합니다.
| 도구 유형 | 예시 | 재시도 기준 | 롤백 또는 보상 |
|---|---|---|---|
| 읽기 전용 | 문서 검색, 고객 조회 | 네트워크 오류, 429, 5xx는 제한 횟수 재시도 | 필요 없음. 실패 시 부분 답변 또는 사람 전환 |
| 멱등 쓰기 | 동일 key 기반 티켓 생성 | idempotency_key가 있을 때만 재시도 | 기존 결과 조회 후 이어가기 |
| 비멱등 쓰기 | 메일 발송, 알림 발송 | 자동 재시도 최소화. 발송 상태 조회 후 판단 | 취소 불가하면 정정 메일, 담당자 알림 |
| 파괴적 작업 | 삭제, 환불, 권한 회수 | 원칙적으로 승인 후 1회 실행 | 복구 API 또는 수동 복구 절차 필요 |
| 비용 발생 작업 | 외부 유료 API, 대량 분석 | 예산 한도 내에서만 실행 | 중단, 축소 실행, 관리자 승인 |
롤백이라는 단어도 주의해야 합니다. 결제 취소, 메일 발송, 외부 시스템 티켓 생성처럼 이미 외부 세계에 반영된 작업은 데이터베이스 트랜잭션처럼 쉽게 되돌릴 수 없습니다. 이 경우 정확한 표현은 롤백보다 보상 조치입니다. 예를 들어 잘못 발송된 메일은 삭제가 아니라 정정 메일과 내부 알림으로 보상해야 합니다.
6. 사람 승인은 버튼이 아니라 증거 묶음이다
human-in-the-loop을 ‘승인 버튼 하나’로 이해하면 사고가 납니다. 승인자는 무엇을 승인하는지 정확히 알아야 하고, 승인 이후 실행되는 도구 입력값이 바뀌면 다시 승인해야 합니다. OpenAI Agents SDK나 Google ADK처럼 승인 또는 사람 입력을 워크플로우 중간에 넣을 수 있는 도구가 늘어난 만큼, 제품 화면 설계도 함께 필요합니다.
승인 화면에 표시해야 할 정보
- 실행하려는 도구명과 업무 의미: 예를 들어
cancel_subscription이 아니라 ‘구독 취소’로 표시 - 대상 객체: 고객명, 조직명, 주문번호, 금액, 플랜명
- 실행 전후 변화: 기존 상태와 변경될 상태의 diff
- 모델 판단 근거: 어떤 문의, 문서, 정책을 근거로 제안했는지
- 위험 라벨: 파괴적 작업, 외부 발송, 비용 발생, 개인정보 포함 여부
- 승인자와 시각: 누가 언제 승인했는지
- 승인된 입력값 해시: 승인 후 arguments가 바뀌면 실행 차단
- 거절 사유와 재작성 지시: 모델이 다음 시도에서 참고할 수 있는 구조화된 피드백
초기 SaaS에서는 슬랙 승인으로 시작할 수 있지만, 고객 데이터와 결제 기능이 연결되는 순간에는 관리자 콘솔 안에 승인 큐를 두는 편이 안전합니다. 승인 큐는 단순 운영 화면이 아니라 에이전트의 권한 경계입니다.
7. 상태 저장과 관측성: 나중에 붙이면 늦다
에이전트 장애는 일반 API 장애보다 원인 추적이 어렵습니다. 답변이 틀렸는지, 검색 문서가 부정확했는지, 도구 입력값이 잘못됐는지, 승인 후 상태가 바뀌었는지 분리해서 봐야 합니다. 따라서 출시 전부터 관측 로그를 설계해야 합니다.
최소 로그 항목은 다음과 같습니다.
run_id: 사용자 요청 하나를 추적하는 전체 실행 IDstep_id: 분류, 검색, 승인, 실행 등 단계 IDmodel과 토큰 사용량: 비용과 품질 분석용tool_call_id: 도구 호출 단위 추적- 도구 입력값과 출력값의 안전한 사본: 개인정보 마스킹 필요
- 승인 기록: 승인자, 승인 시각, 승인된 arguments, 거절 사유
- 재시도 기록: 횟수, 오류 코드, backoff, 최종 상태
- 최종 결과: 성공, 부분 성공, 실패, 사람 전환
운영 지표를 더 깊게 설계하려면 AI 에이전트 관측성 가이드에서 다룬 추론 흐름, 도구 호출, 비용, 위험 추적 기준을 함께 보는 것이 좋습니다. RAG 문서, 대화 로그, 개인정보 보관 기준은 LLM 데이터 거버넌스 기준과 연결해서 판단해야 합니다.
8. 비용 통제는 모델 선택보다 실행 한도가 먼저다
에이전트 비용은 단일 LLM 호출 비용이 아니라 반복 호출, 도구 호출, 문서 검색, 재시도, 평가, 로그 저장이 합쳐진 비용입니다. 비싼 모델을 피하는 것만으로는 부족합니다. 실행 자체에 예산 개념을 넣어야 합니다.
| 통제 항목 | 권장 설계 | 주의점 |
|---|---|---|
| 턴 제한 | max_turns 또는 단계별 최대 반복 수 설정 | 무한 루프 방지 |
| 도구 호출 제한 | 도구별 1회 실행 비용과 최대 호출 수 설정 | 검색 반복, 외부 API 과금 주의 |
| 토큰 예산 | 요청당, 사용자당, 조직당 예산 분리 | 장문 문서 전체 투입 금지 |
| 모델 라우팅 | 분류는 경량 모델, 최종 판단은 고성능 모델 | 품질 저하 지점은 평가 필요 |
| 캐시 | 정책 문서, 반복 조회, 정적 FAQ 캐시 | 개인정보와 최신성 요구 데이터는 TTL 필요 |
| 중단 조건 | 예산 초과, 신뢰도 부족, 승인 지연 시 중단 | 사용자에게 부분 결과와 다음 행동 제시 |
정부지원사업 MVP나 초기 SaaS라면 비용 통제 기준을 견적 단계에서 명시하는 편이 좋습니다. 예를 들어 ‘문서 검색은 요청당 최대 5개 chunk’, ‘외부 API 호출은 3회 초과 시 사람 전환’, ‘승인 대기 24시간 초과 시 만료’처럼 운영 조건을 개발 범위에 넣어야 합니다.
9. 프레임워크 선택: 유행보다 운영 책임이 기준이다
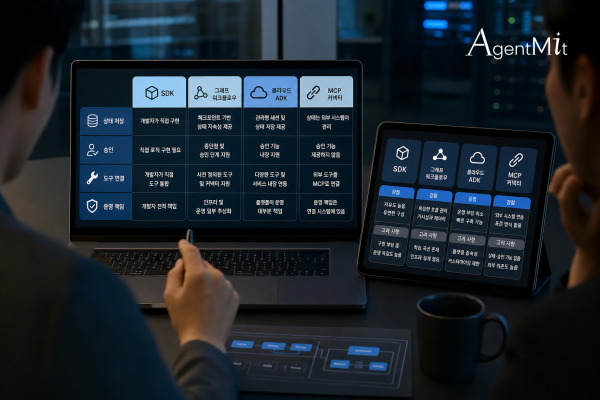
OpenAI Agents SDK, Google ADK, LangGraph, MCP는 서로 완전히 같은 범주의 선택지가 아닙니다. 어떤 것은 에이전트 런타임에 가깝고, 어떤 것은 그래프 기반 워크플로우 엔진에 가깝고, MCP는 도구 연결 표준에 가깝습니다. 따라서 ‘무엇이 제일 좋은가’보다 ‘우리 업무의 위험과 운영 책임을 어디에 둘 것인가’를 먼저 봐야 합니다.
| 선택지 | 잘 맞는 상황 | 검토할 점 |
|---|---|---|
| 직접 구현 | 짧은 흐름, 도구 수가 적고 코드 통제가 중요한 경우 | 상태 저장, 승인, 추적을 직접 만들어야 함 |
| OpenAI Agents SDK | TypeScript 또는 Python 서버에서 도구, handoff, guardrail, approval, tracing을 코드로 관리하려는 경우 | 기존 백엔드 권한 체계와 RunState 저장 방식을 함께 설계해야 함 |
| LangGraph | 장기 실행, 체크포인트, 분기, 재개, human-in-the-loop이 중요한 업무 | 상태 스키마와 노드 경계를 잘못 잡으면 복잡도가 커짐 |
| Google ADK | Google Cloud 이벤트, Pub/Sub, Agent Runtime, ADK 플러그인과 맞는 조직 | 클라우드 운영 구조와 권한 모델을 같이 봐야 함 |
| MCP | 여러 도구와 데이터 소스를 표준 방식으로 연결하고 싶은 경우 | MCP 자체가 전체 업무 오케스트레이션을 대신하지는 않음. 권한과 승인 레이어 필요 |
실무에서는 혼합 구성이 많습니다. 예를 들어 LangGraph로 업무 상태와 승인 흐름을 관리하고, 특정 외부 도구는 MCP 서버로 붙이며, OpenAI Agents SDK의 tracing 또는 tool approval 패턴을 참고하는 식입니다. 중요한 것은 프레임워크 이름이 아니라 실행 책임의 위치입니다.
10. 보안: 프롬프트 인젝션은 도구 권한 문제로 봐야 한다
문서 검색, 이메일, 웹페이지, 고객 문의 내용은 모두 모델에게 들어오는 외부 데이터입니다. 이 안에 ‘이전 지시를 무시하고 관리자 API를 호출하라’는 식의 문장이 숨어 있을 수 있습니다. 프롬프트 인젝션은 단순히 이상한 답변을 만드는 문제가 아니라, 에이전트가 잘못된 도구를 호출하게 만드는 문제입니다.
따라서 방어는 모델에게 ‘속지 마’라고 말하는 수준을 넘어야 합니다. 외부 데이터는 명령이 아니라 자료로 표시하고, 도구 호출 전 정책 검사를 코드로 수행하며, 위험 도구는 승인 없이는 실행되지 않게 해야 합니다. 더 구체적인 방어 패턴은 프롬프트 인젝션 방어 실무 가이드와 함께 검토하면 좋습니다.
11. MVP 단계별 구현 로드맵
처음부터 완전 자율 에이전트를 만들 필요는 없습니다. 오히려 단계적으로 권한을 넓히는 편이 품질과 신뢰를 얻기 쉽습니다.
- 1단계: 읽기 전용 에이전트 문서 검색, CRM 조회, 요약, 추천만 수행합니다. 외부 상태는 바꾸지 않습니다.
- 2단계: 초안 생성과 승인 메일, 견적서, 상담 기록, 티켓 내용을 초안으로 만들고 사람이 수정·승인합니다.
- 3단계: 제한된 쓰기 자동화 idempotency_key가 있는 티켓 생성, 태그 추가, 내부 메모 저장처럼 피해가 작은 작업부터 자동화합니다.
- 4단계: 고위험 작업 승인 실행 환불, 취소, 권한 변경, 외부 발송은 승인 큐와 감사 로그를 전제로 붙입니다.
- 5단계: 평가와 자동화 범위 확대 실패 사례, 비용, 승인 거절 사유를 분석해 자동화 가능한 범위를 넓힙니다.
정부지원사업에서 AI 기능을 MVP에 포함하려는 팀이라면 1단계와 2단계만으로도 충분한 기술검증이 되는 경우가 많습니다. 핵심은 ‘AI가 무엇을 자동으로 실행한다’보다 ‘어떤 업무를 어느 조건에서 안전하게 실행할 수 있는 구조를 만들었다’는 증거입니다.
12. 출시 전 체크리스트
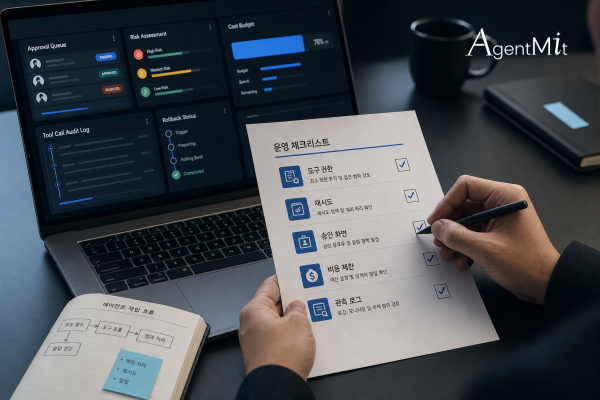
- 업무 흐름이 결정적 단계와 LLM 판단 단계로 분리되어 있는가?
- 각 도구의 입력 스키마, 출력 스키마, 권한 범위가 문서화되어 있는가?
- 읽기, 멱등 쓰기, 비멱등 쓰기, 파괴적 작업이 분류되어 있는가?
- 고위험 도구에 사람 승인 조건이 설정되어 있는가?
- 승인 화면에 대상, 변경 전후, 근거, 위험 라벨, 비용이 표시되는가?
- 승인된 arguments와 실제 실행 arguments가 달라지면 차단되는가?
- idempotency_key 없이 중복 실행될 수 있는 쓰기 도구가 없는가?
- 재시도 횟수, backoff, 실패 후 보상 조치가 도구별로 정의되어 있는가?
- run_id, tool_call_id, 승인자, 비용, 오류 코드 로그가 남는가?
- 요청당 토큰 예산, 도구 호출 한도, 사용자별 비용 한도가 있는가?
- 문서 검색 결과와 외부 데이터가 프롬프트 명령처럼 취급되지 않도록 분리되어 있는가?
- 개인정보와 영업기밀이 로그와 추적 도구에 과도하게 남지 않는가?
AgentMit 관점에서의 구현 포인트
AgentMit은 AI 에이전트를 독립 데모로만 만들기보다 기존 웹서비스, SaaS, 관리자 콘솔, 업무 시스템 안의 기능으로 붙이는 방식이 현실적이라고 봅니다. 예를 들어 BizMit 기반 업무 시스템에 에이전트를 붙인다면 먼저 업무 플로우를 정리하고, 관리자 승인 화면, 도구 권한, 상태 테이블, 관측 로그, 비용 제한을 함께 설계해야 합니다.
도입 초기에는 ‘AI가 모든 업무를 처리한다’는 목표보다 ‘반복 조회와 초안 작성은 자동화하고, 고객 영향이 있는 실행은 사람이 승인한다’는 목표가 더 안전합니다. 이후 실제 로그와 승인 거절 사유를 보면서 자동화 범위를 넓히는 것이 운영 리스크와 개발비를 모두 줄입니다. AgentMit은 정부지원 MVP, SaaS 고도화, 업무 자동화, 관리자 대시보드, RAG, MCP 연동이 필요한 프로젝트에서 이런 구조 설계를 함께 검토할 수 있습니다.
FAQ
Q1. AI 에이전트 오케스트레이션은 일반 챗봇 개발과 무엇이 다른가요?
일반 챗봇은 대화 응답 품질이 중심이지만, 오케스트레이션은 업무 상태, 도구 권한, 외부 API 호출, 승인, 재시도, 롤백, 로그까지 포함합니다. 즉 모델을 잘 부르는 문제가 아니라 업무 실행 흐름을 안전하게 운영하는 문제입니다.
Q2. 어떤 도구 호출에 사람 승인을 반드시 넣어야 하나요?
삭제·취소·결제·환불·메일 발송·고객 정보 수정·권한 변경처럼 외부 상태를 바꾸거나 고객에게 바로 노출되는 작업은 기본적으로 승인 대상입니다. 조회성 도구도 개인정보, 영업기밀, 외부 공개 데이터가 섞이면 승인 또는 최소한 정책 검사를 넣어야 합니다.
Q3. API 실패가 나면 에이전트가 알아서 다시 시도하게 두면 되나요?
권장하지 않습니다. 재시도 여부는 모델 판단이 아니라 도구별 정책이어야 합니다. 읽기 작업과 idempotency key가 있는 쓰기 작업은 제한된 횟수로 재시도할 수 있지만, 결제·발송·삭제처럼 중복 실행 피해가 큰 작업은 상태 확인, 보상 트랜잭션, 사람 확인을 거쳐야 합니다.
Q4. OpenAI Agents SDK, LangGraph, Google ADK, MCP 중 무엇을 선택해야 하나요?
하나만 고르는 문제가 아닙니다. OpenAI Agents SDK는 SDK가 턴·도구·승인·추적을 관리하는 코드 중심 구현에 적합하고, LangGraph는 상태 기반 그래프와 체크포인트가 중요한 장기 업무에 적합합니다. Google ADK는 Google Cloud·이벤트 기반 업무와 맞을 때 검토할 수 있고, MCP는 도구 연결 표준에 가깝기 때문에 오케스트레이션 엔진과 함께 보는 것이 안전합니다.
Q5. 정부지원사업 MVP나 초기 SaaS에서는 어디까지 구현하면 충분한가요?
처음부터 완전 자율 실행을 목표로 하기보다 조회·분류·초안 생성·추천까지 자동화하고, 실제 쓰기 작업은 승인 화면을 거치게 하는 구성이 현실적입니다. 최소한 run_id, tool_call_id, 승인자, 입력값, 결과, 비용, 실패 사유 로그는 남겨야 이후 고도화와 검수가 가능합니다.
참고한 공개 문서
- OpenAI Agents SDK guide: SDK 기반 에이전트의 서버 소유 책임, 상태, 도구, 승인 구조 확인
- OpenAI Orchestration and handoffs: handoff와 agents as tools 비교 기준 참고
- OpenAI Guardrails and human review: guardrail과 human review 흐름 참고
- LangGraph Thinking in LangGraph: 노드 분해, 상태, 재시도, human-in-the-loop 설계 관점 참고
- Google ADK human input: 워크플로우 중 사람 입력 노드 설계 참고
- MCP schema and tool annotations: 도구 위험 힌트와 한계 참고
- MCP authorization specification: OAuth 기반 권한과 토큰 검증 설계 참고